Faire écouter un extrait d'un morceau avant de l'acheter paraît simple : une balise <audio>, un lien vers le MP3, et c'est réglé. Ça tient jusqu'à ce que le catalogue dépasse plusieurs centaines de milliers de titres, que les fichiers originaux soient justement ce qu'on vend, et que le lecteur doive démarrer instantanément sur mobile comme sur desktop.
J'ai donc construit un pipeline qui encode les titres en HLS. Il repose sur Laravel, quelques services AWS (files de messages, fonction serverless, stockage objet, CDN) et Vue.js.
Le problème
Le lecteur doit démarrer tout de suite, sans télécharger un MP3 entier avant d'émettre un son. Il ne doit jamais exposer le fichier source, puisque c'est le produit vendu. Il faut aussi encoder l'existant, plusieurs centaines de milliers de titres, puis chaque nouveau titre au fil de l'eau.
Une contrainte contractuelle s'ajoute : les licences couvrent le téléchargement, pas le streaming. La préécoute se coupe donc d'elle-même au bout de 90 secondes, et il faut relancer la lecture pour continuer. On ne peut en revanche pas se contenter d'un extrait : les DJ qui utilisent la plateforme doivent pouvoir parcourir tout le morceau pour repérer les drops, l'énergie, etc.
Pourquoi HLS plutôt qu'un simple MP3
HLS découpe l'audio en petits segments de quelques secondes, listés dans un fichier d'index (.m3u8). Le lecteur télécharge le premier segment, démarre, puis enchaîne. Le démarrage ne dépend plus de la taille du fichier, et un saut dans la timeline ne charge que les segments nécessaires. Surtout, le flux devient un artefact distinct de l'original : on peut le protéger, le purger ou le régénérer sans toucher au produit vendu.
J'ai gardé une seule qualité (AAC stéréo 192 kbit/s) et des segments de 10 secondes. Le streaming adaptatif multi-débits n'apporterait rien pour une préécoute qui se coupe toutes les 90 secondes.
L'architecture en un coup d'œil
Schéma du pipeline : Laravel, file de messages, fonction serverless ffmpeg, stockage objet, file de retour, base de données, CDN et navigateur.
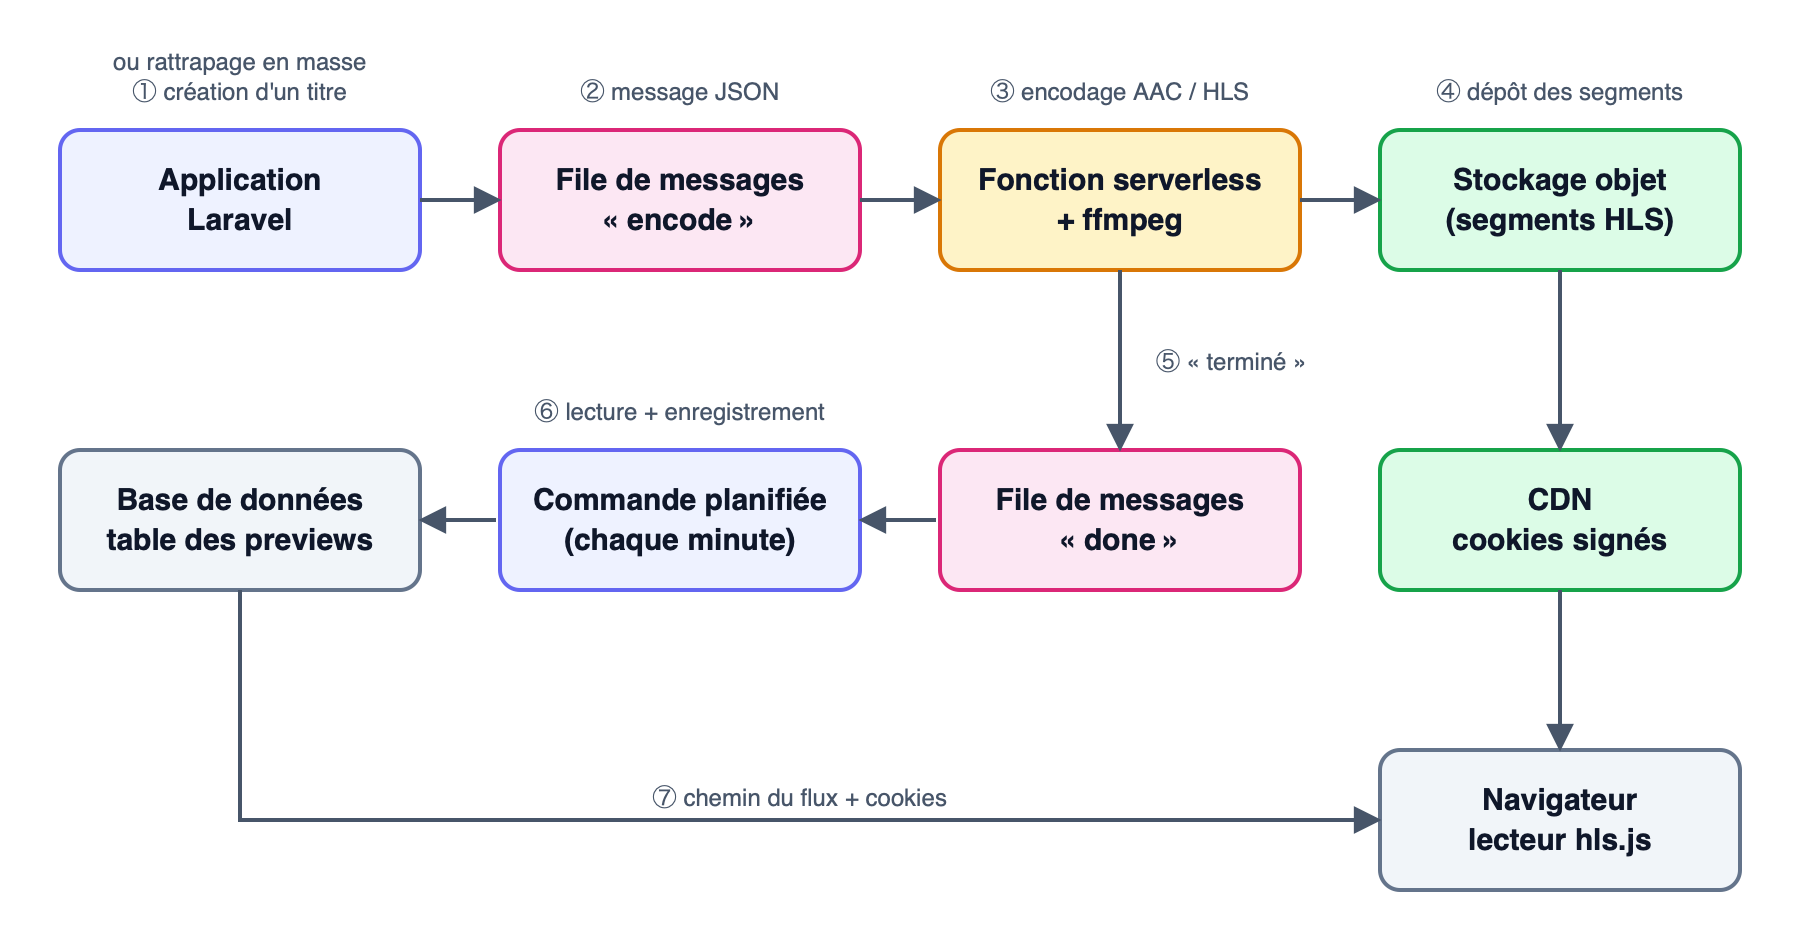
Laravel ne fait jamais l'encodage. Il publie une demande dans une file, une fonction serverless l'exécute, et une seconde file lui annonce que c'est terminé. Chaque sens a son propre message, et l'application n'a aucun lien direct avec le worker.
Tout repose sur deux petits messages JSON. À l'aller, ce que Laravel demande :
{
  "type": "track",
  "audio_id": 123456,
  "bucket": "bucket-source",
  "s3_key": "audio_id.mp3"
}
Au retour, ce que le worker répond :
{
  "type": "stem",
  "audio_id": 123456,
  "hls_path": "audio_id/index.m3u8",
  "encoded_at": "2026-06-02T10:15:42+00:00"
}
Le champ type permet de faire passer par le même circuit deux familles de fichiers : les titres entiers et les pistes séparées (les stems). Le worker ne connaît ni mon schéma de base de données ni mes modèles. Il reçoit un identifiant et le renvoie tel quel.
Le dossier HLS porte le nom de la clé source sans l'extension, donc aucune table de correspondance à maintenir : le chemin se déduit.
Un observer Eloquent publie la demande dès la création d'un titre. Si l'envoi échoue, l'erreur est journalisée mais la création continue.
public function created(Audio $audio): void
{
    try {
        $sqs->sendMessage([
            'QueueUrl'    => config('services.sqs.encode_queue_url'),
            'MessageBody' => json_encode([
                'type'        => 'mp3',
                'download_id' => $audio->id,
                'bucket'      => $bucket,
                's3_key'      => $audio->file,
            ]),
        ]);
    } catch (\Exception $e) {
        \Log::error('HLS enqueue failed for audio #'.$audio->id.': '.$e->getMessage());
    }
}
Pour le catalogue existant, une commande Artisan qui envoie tout ce qui n'a pas encore de preview. C'est elle qui a encodé l'historique du catalogue, par paquets de 5000, avec une option --limit pour tester sur une poignée de titres avant de lancer le reste.
AWS : une fonction et un binaire
La file « encode » déclenche une fonction serverless en Python qui embarque ffmpeg grâce à une couche (layer) dédiée. Elle télécharge le MP3 source, l'encode en AAC en le segmentant, dépose l'index et les segments dans un bucket distinct de celui des originaux, puis publie le message « terminé » dans la seconde file.
ffmpeg -i input.mp3 -vn -ac 2 -acodec aac -b:a 192k \
  -f segment -segment_format mpegts -segment_time 10 \
  -segment_list index.m3u8 segment_%03d.ts
J'ai choisi du serverless plutôt qu'un serveur d'encodage à cause de la forme de la charge : un énorme pic le jour du rattrapage, puis quelques titres par jour. Un serveur dimensionné pour le pic dormirait presque tout le temps. Une fonction déclenchée par une file monte en charge toute seule et ne coûte rien quand il n'y a rien à encoder.
Pour récupérer les résultats, j'ai évité le webhook entrant, qu'il faut sécuriser, pouvoir rejouer et dimensionner. Laravel vient chercher les messages lui-même : une commande planifiée lit chaque minute jusqu'à 100 messages de la file « done ».
Les segments sont servis par un CDN placé devant un stockage privé. Reste à décider qui a le droit de les lire. Une URL signée par fichier ne convient pas à HLS : un morceau, c'est un index et des dizaines de segments que le lecteur réclame au fil de la lecture. J'utilise donc des cookies signés. L'API en émet un quand l'utilisateur lance la lecture, et ce cookie autorise le lecteur à récupérer tous les segments du flux pendant une durée limitée.
Coûts à prévoir
Encoder tout le catalogue (plusieurs centaines de milliers de titres) a coûté environ 70 $ de calcul serverless, une seule fois. Les files de messages représentent moins de 1 $ au total. Le CDN, lui, coûte quelques centaines de dollars par mois selon la fréquentation. Un cout relatif puisqu'il existait déjà auparavant lors de la distribution en mp3. Il est même réduit puisque le mp3 n'est plus chargé entièrement. L'économie est d'environ 15 à 20%.
L'encodage, qui m'avait paru le sujet le plus intimidant, est donc le moins cher. L'essentiel de la facture vient de la diffusion. Ce CDN ne s'ajoute pas simplement au reste : il prend la place d'une partie du trafic qui sortait auparavant directement du stockage.